
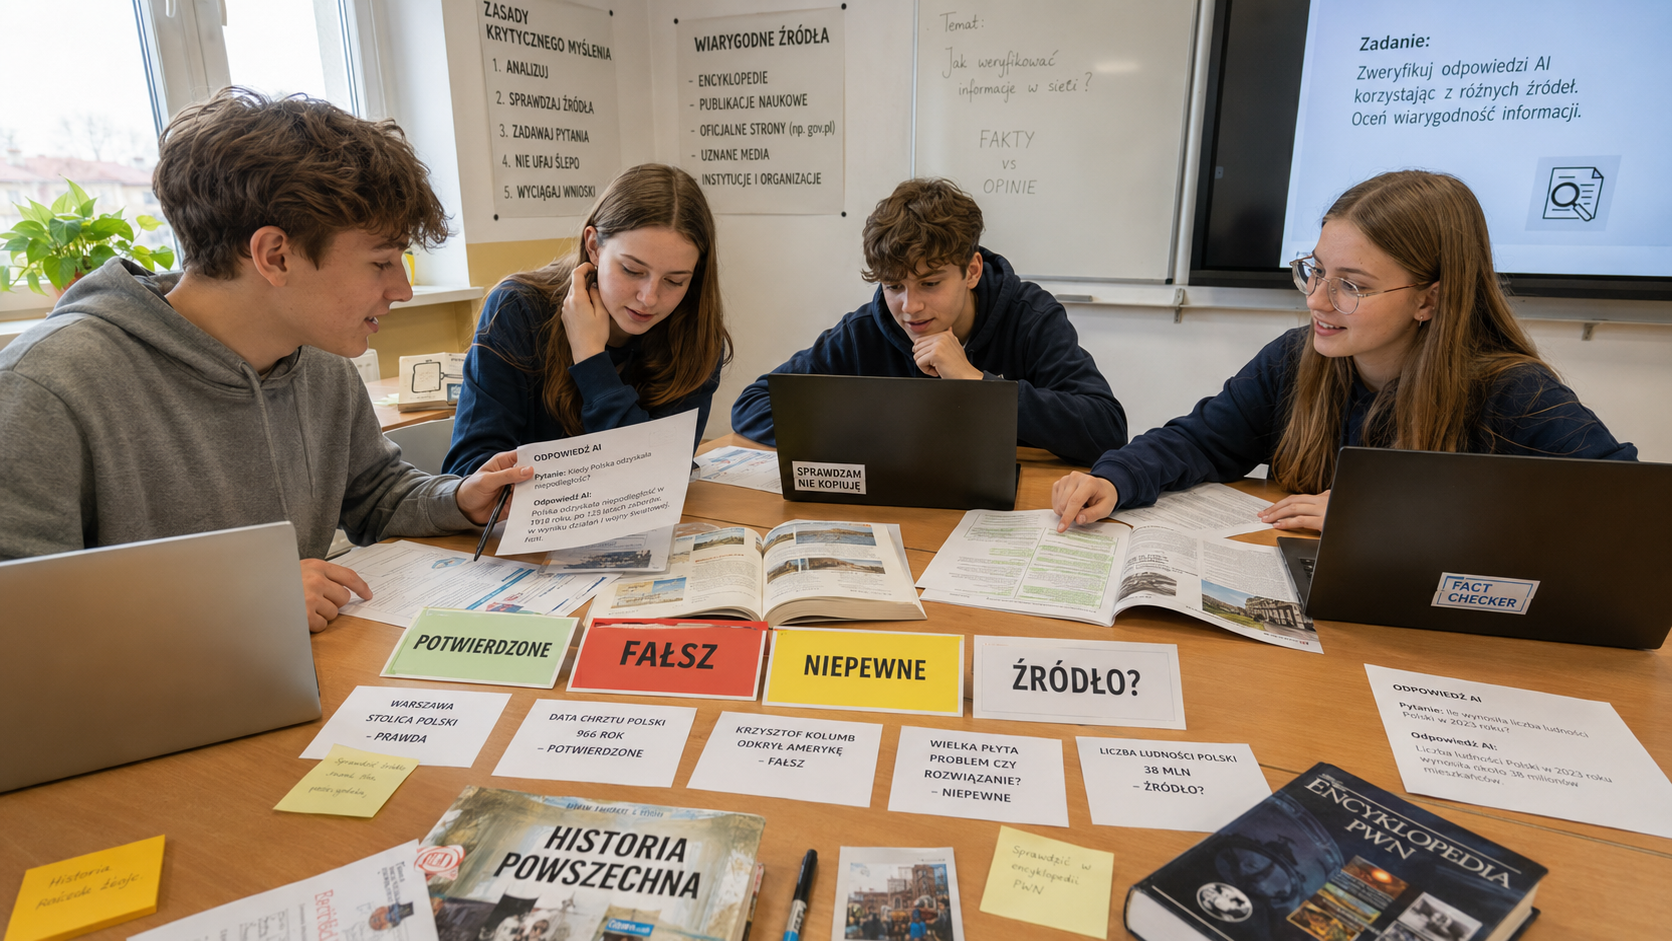
 Czyli jak przełożyć halucynacje, zmyślone źródła i wiarygodnie brzmiące błędy chatbotów na ćwiczenie krytycznego myślenia u uczniów?
Chatbot potrafi wymyślić nieistniejący artykuł naukowy, pomylić daty wydarzeń, przypisać komuś cytat, którego nigdy nie wypowiedział. Czasami łączy kilka prawdziwych faktów w zdanie, które po polsku brzmi sensownie i logicznie, a jednak jest całkowitą nieprawdą. Co na to nauczyciel? Normalnie poprawiłby, wskazał dobrą odpowiedź i przestrzegł uczniów, że sztucznej inteligencji nie można ufać bez zastrzeżeń, bo przecież „halucynuje”.
A gdyby jednak zostawić ten błąd?
Błędna odpowiedź wygenerowana przez AI to w gruncie rzeczy świetny materiał do lekcji. Można ją rozebrać na części, sprawdzić każdy punkt, poszukać źródeł, porównać dane, ocenić, na ile można jej zaufać, a potem poprawić i zastanowić się, dlaczego to fałszywe zdanie jest aż tak przekonujące. Wtedy uczeń nie tylko bezmyślnie kopiuje treść wyplutą przez maszynę. Zaczyna działać jak recenzent, a czasem nawet jak detektyw, który szuka prawdy po poszlakach.
I właśnie wtedy lekcja robi się naprawdę interesująca.
Właśnie tym tematem zajęliśmy się razem z moimi uczniami z Zespołu Placówek Edukacyjnych w Olsztynie, pracując nad projektem eTwinning „Digital Citizens: Together in the Digital World”. Rozmawialiśmy o tym, co dziś naprawdę znaczy bycie cyfrowym obywatelem: o bezpieczeństwie, odpowiedzialności, mądrzejszym korzystaniu z sieci i o sztucznej inteligencji. Nie interesowało mnie, żeby zatrzymać się tylko na oklepanych zaleceniach w stylu „uważaj na fake newsy”. W trakcie projektu uczniowie tworzyli swoje cyfrowe materiały: komiksy, podcasty, grafiki, miniaplikacje, a nawet grę komputerową. Treści wygenerowane przez AI traktowaliśmy nie jako gotowce, tylko jak coś do przeczytania, poprawienia, poddania ocenie. Dopiero po tym decydowaliśmy, czy taki materiał warto wykorzystać. W praktyce szybko się okazało, że najważniejsze wcale nie jest to, co wpiszesz do AI, tylko co zrobisz z jej odpowiedzią. Decyzja, ile możesz z tej treści naprawdę wyciągnąć – to jest sedno sprawy.
Największy kłopot nie zaczyna się wtedy, kiedy AI popełni błąd
Jeszcze niedawno uczeń mógł się trzymać dość sensownej strategii. Jeśli tekst był napisany konkretnie, z użyciem specjalistycznych pojęć i bibliografii, można było założyć, że stoi za tym ktoś, kto się zna. Generatywna AI skutecznie podważyła ten schemat zaufania. Tekst, który wygląda na profesjonalnie napisany, dziś da się wygenerować w kilka sekund. Styl nie jest już wyznacznikiem wiedzy. Chatbot ma tu nawet przewagę nad uczniem, który nie zna odpowiedzi. AI się nie zawaha się, nie zamyśli, nie zająknie. Potrafi napisać cały akapit zupełnie błędnych informacji, choć całość brzmi poważnie i przekonująco.
Mechanizm „zgadywania” przez modele AI i jego skutki opisuje m.in. artykuł w „Nature” – „Evaluating large language models for accuracy incentivizes hallucinations”. Trzy popularne modele (ChatGPT, Claude i DeepSeek) zapytano o rozwinięcie niejednoznacznego skrótu „PGGB”, bez żadnego kontekstu. Zamiast poprosić o wyjaśnienie, albo przyznać, że nie wiedzą, modele podały konkretne, i całkowicie wymyślone, rozwinięcia. Wszystkie były błędne. To świetny przykład, bo nie chodzi tu o szczegółowe informacje z datami czy nazwiskami. Każdy model stworzył swoją wersję faktów, która brzmiała wiarygodnie. Takie definicje bez zastanowienia moglibyśmy skopiować do prezentacji czy pracy domowej.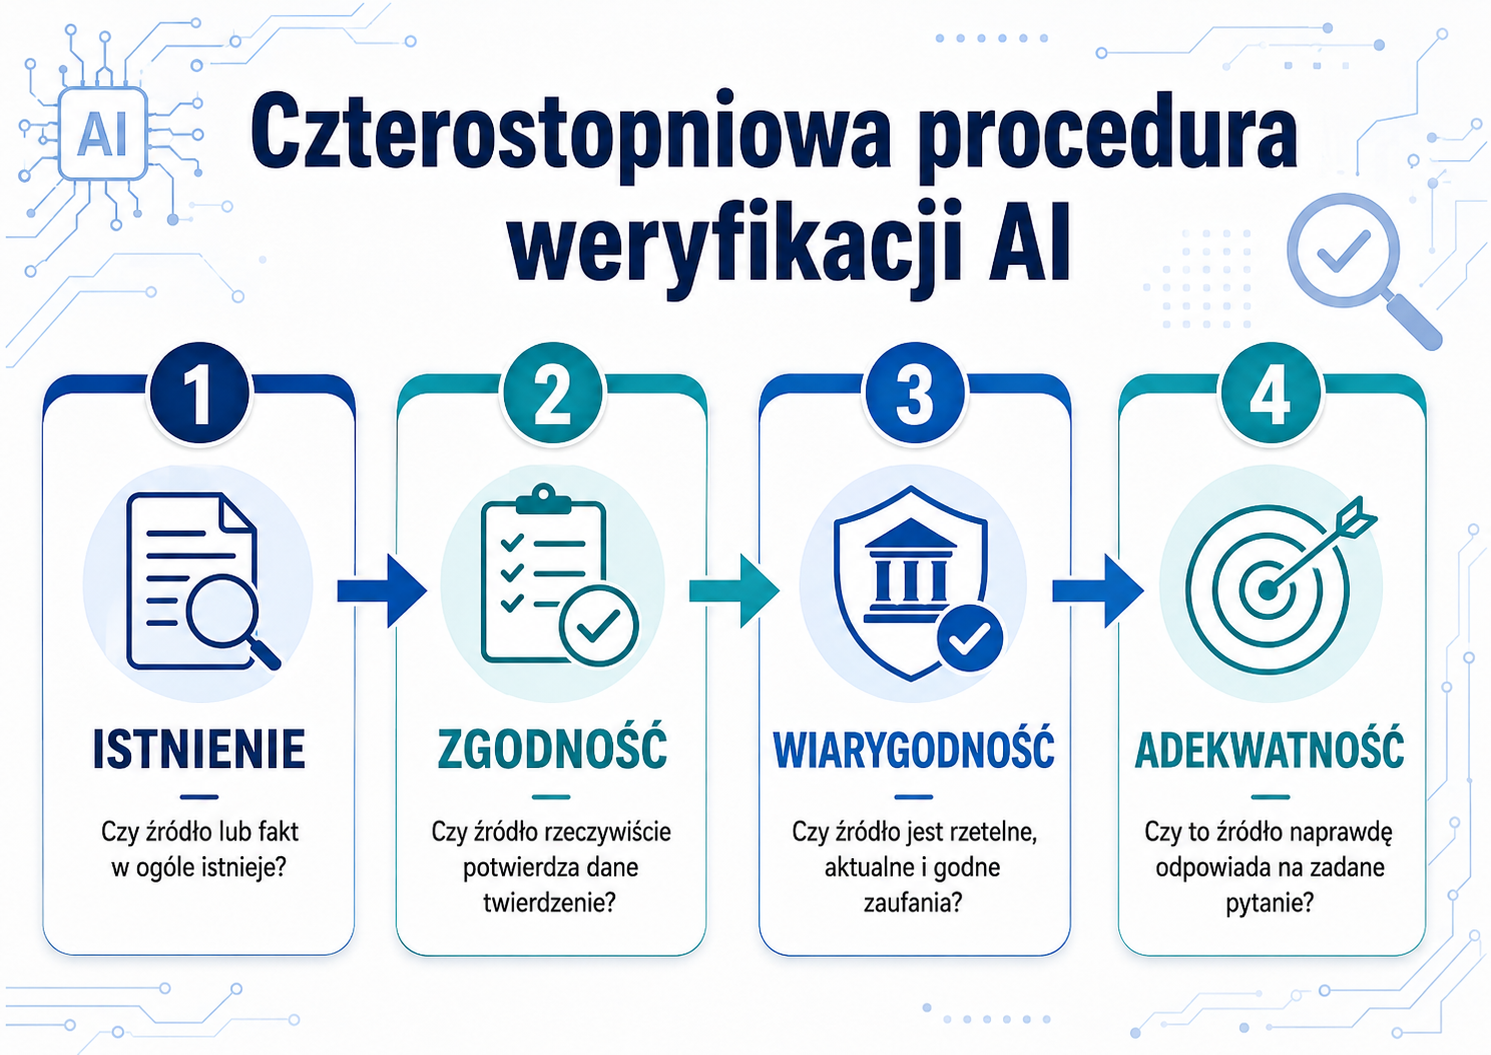
Takich efektownych wpadek chatbotów można by wymieniać bez końca. W sierpniu tego roku gorąco dyskutowano nad raportem „Polaków Portret Własny. Raport z badań DNA marki Polska”. Dziennikarze i eksperci wytykali w nim błędy językowe, nieścisłości metodologiczne, podejrzane źródła i wykorzystanie generatywnej AI. Barbara Mróz-Gorgoń przyznała, że podczas pracy nad dokumentem korzystano ze sztucznej inteligencji, ale podkreśliła od razu, że AI pomagała tylko przy transkrypcji, streszczeniu i redakcji, nie przy projektowaniu badań czy formułowaniu wniosków. Właśnie dlatego tak ważne jest, aby nie opierać się na jednym nagłówku, tylko sięgnąć do różnych źródeł, gdyż zarówno przy tworzeniu raportu, jak i pracy dziennikarskiej, popełniono wiele błędów, tworzące dwie sprzeczne rzeczywistości.
Patrząc pod kątem edukacji, ta polska sprawa wskazuje na coś więcej niż kolejną „wpadkę AI”. Problem zaczyna się wtedy, gdy tekst idzie z rąk do rąk, a nikt nawet nie próbuje zatrzymać się i sprawdzić jego sensu czy zbadać źródła. To dokładnie to, na co powinniśmy uczulić uczniów. Jeśli młoda osoba potraktuje tekst od AI jak wersję roboczą, materiał do sprawdzenia, a nie gotowy produkt, zwiększa to szansę, że taki nawyk zabierze potem na studia, do pracy, a nawet w życie publiczne.
Możliwa jest przecież sytuacja, gdzie artykuł istnieje, autor jest prawdziwy, link działa, a jednak publikacja mówi coś zupełnie innego niż przypisał jej chatbot. Dlatego przydaje się prosty, czterostopniowy schemat: istnienie -> zgodność -> wiarygodność -> adekwatność. Najpierw sprawdzamy, czy źródło naprawdę jest. Potem, czy faktycznie zawiera tę informację, na którą powołuje się AI. Następnie oceniamy jakość źródła. Na końcu, czy jest ono odpowiednie, by rozstrzygnąć dane pytanie.
Podejście, żeby specjalnie pracować na błędnych odpowiedziach chatbotów, to nie tylko eksperyment na papierze. W badaniu NASK o generatywnej AI w polskiej szkole nauczyciele opisywali sytuacje, gdzie na lekcjach rozmawiali z ChatGPT, celowo prowokując błędne odpowiedzi, by pokazać uczniom, jak ważne jest weryfikowanie takich treści. Sam raport NASK „Generatywna sztuczna inteligencja w polskiej szkole. Przecieranie szlaków” można znaleźć na stronie instytutu.
Zróbmy AUDYT AI
Zamiast udawać, że technologia nie popełnia błędów, lepiej pokazać jej ograniczenia na własnych warunkach. Nie chodzi tu jednak o konkurs pn. „kto pierwszy złapie ChatGPT na kłamstwie”, gdyż jest to równie szkodliwe jak ślepa wiara w AI. Uczeń powinien wyjść z lekcji nie z przekonaniem, że „AI zawsze kłamie”, ale z odruchem, by odpowiedzi AI traktować jak tezy, które czasem trzeba sprawdzić.
Jak z tej koncepcji zrobić zwykłą lekcję? W praktyce wystarczy kilka prostych kroków, które, razem z uczniami, nazwaliśmy AUDYT AI:
- A- Atomizuj.Rozbij odpowiedź na pojedyncze twierdzenia. W jednym długim zdaniu potrafią ukryć się nawet trzy czy cztery niezależne informacje, z których każdą należy sprawdzić osobno.
- U- Ustal, co można zweryfikować.Oddziel fakty od opinii, interpretacji oraz przypuszczeń.
- D- Dowody.Poszukaj najlepszego dostępnego źródła – najlepiej, jeśli to źródło pierwotne albo instytucja.
- Y- „Yyy… skąd to wiadomo?”Sam link to za mało. Sprawdź dokładnie, czy źródło faktycznie potwierdza każdą informację.
- T- Tryb werdyktu.Oznacz dane jako potwierdzone, błędne, wprowadzające w błąd lub nierozstrzygalne na podstawie dostępnych dowodów. Następnie popraw odpowiedź.
Gdy razem z uczniami układaliśmy taki, trochę żartobliwy, schemat, dotarło do mnie, że w gruncie rzeczy uporządkowaliśmy po prostu to, co i tak robiliśmy podczas naszego projektu. Nie dotyczył on wyłącznie AI, ale właściwie każde sensowne korzystanie z informacji prowadzi do podobnego ciągu: przeczytaj, zatrzymaj się, sprawdź, porównaj, podejmij decyzję, a dopiero na końcu udostępnij lub korzystaj z informacji. AUDYT AI sprawdza się więc nie tylko przy chatbotach- to ćwiczenie z cyfrowej odpowiedzialności.
Sam natomiast dodałbym do niego jeszcze jedno, bonusowe pytanie: dlaczego uwierzyliśmy danej odpowiedzi? Przez szczegółowość? Fachowe słowa? Pewny styl? Cytaty? Z lenistwa? Albo może dlatego, że zgadza się z tym, co już wcześniej uważaliśmy za prawdę? Ta ostatnia warstwa jest wyjątkowo istotna. Sztuczna inteligencja daje pretekst, by zastanowić się, dlaczego człowiek ufa akurat danej informacji z systemu i jakie mechanizmy pchają nas w stronę wiarygodności.
Sąd nad AI
 Jednym z pomysłów wykorzystujący AUDYT AI, to tzw. lekcja „Sąd nad odpowiedzią AI”. Tu nie potrzeba zaawansowanego sprzętu ani nawet dostępu do chatbota dla uczniów. Wystarczy, że nauczyciel wcześniej przygotuje odpowiedź AI na 150-250 słów i wydrukuje ją na kartce. Najlepiej, by tekst nie był oczywistą bzdurą. Powinien mieć poprawne informacje, kilka drobnych wpadek i jeden wyraźnie wadliwy fragment. Jeśli wszystko byłoby fałszywe, uczniowie tylko zgadywaliby, gdzie jest pułapka, zamiast faktycznie weryfikować treść.
Pierwszych parę minut to czas na indywidualną ocenę. Uczniowie czytają tekst bez internetu i przy każdym fragmencie zaznaczają: „ufam”, „nie ufam” albo „nie wiem”. Mogą też podać, jak bardzo są pewni (na przykład w skali od 0 do 100 procent). Niby drobiazg, ale potem łatwo zauważyć, czy najsilniej przekonani byliśmy właśnie tam, gdzie AI się pomyliła.
Potem trzeba tekst „atomizować”. Przykład: zdanie „Maria urodziła się w X w roku Y i studiowała na uczelni Z” to nie jeden fakt, lecz trzy osobne twierdzenia, które mogą mieć różne oceny.
Następny krok to prawdziwe dochodzenie. Zespoły szukają dowodów i przy każdym sprawdzanym twierdzeniu notują: twierdzenie -> źródło -> konkretny fragment -> werdykt -> poziom pewności. Ważna zasada: „bo znalazłem w Google” nie wystarczy. Google prowadzi do źródła ale samo źródłem nigdy nie jest.
Kolejny etap to krótka rozprawa. Jeden zespół przedstawia dowód, drugi próbuje go podważyć, a reszta klasy ocenia: czy źródło jest wiarygodne, czy faktycznie potwierdza dane zdanie, a może mówi o czymś innym, tylko podobnym?
Na koniec uczniowie odtwarzają odpowiedź, ale nie piszą wszystkiego od początku. Usuwają lub poprawiają tylko to, co nie ma wystarczającego potwierdzenia, a tam, gdzie nie są pewni, uczą się to zaznaczyć: „nie da się stwierdzić na podstawie dostępnych źródeł…”, „najprawdopodobniej…”.
Teraz wracamy do pierwszego werdyktu. Co sprawiło, że problematyczna część wydawała się wiarygodna? Czego nie zauważyliśmy przed szukaniem źródeł? Czy po sprawdzeniu pewność wzrosła, czy spadła? Tak naprawdę najcenniejszy efekt tej lekcji to nie poprawiona odpowiedź sztucznej inteligencji, lecz droga rozumowania, przez którą przechodzi uczeń.
Bibliografia duchów
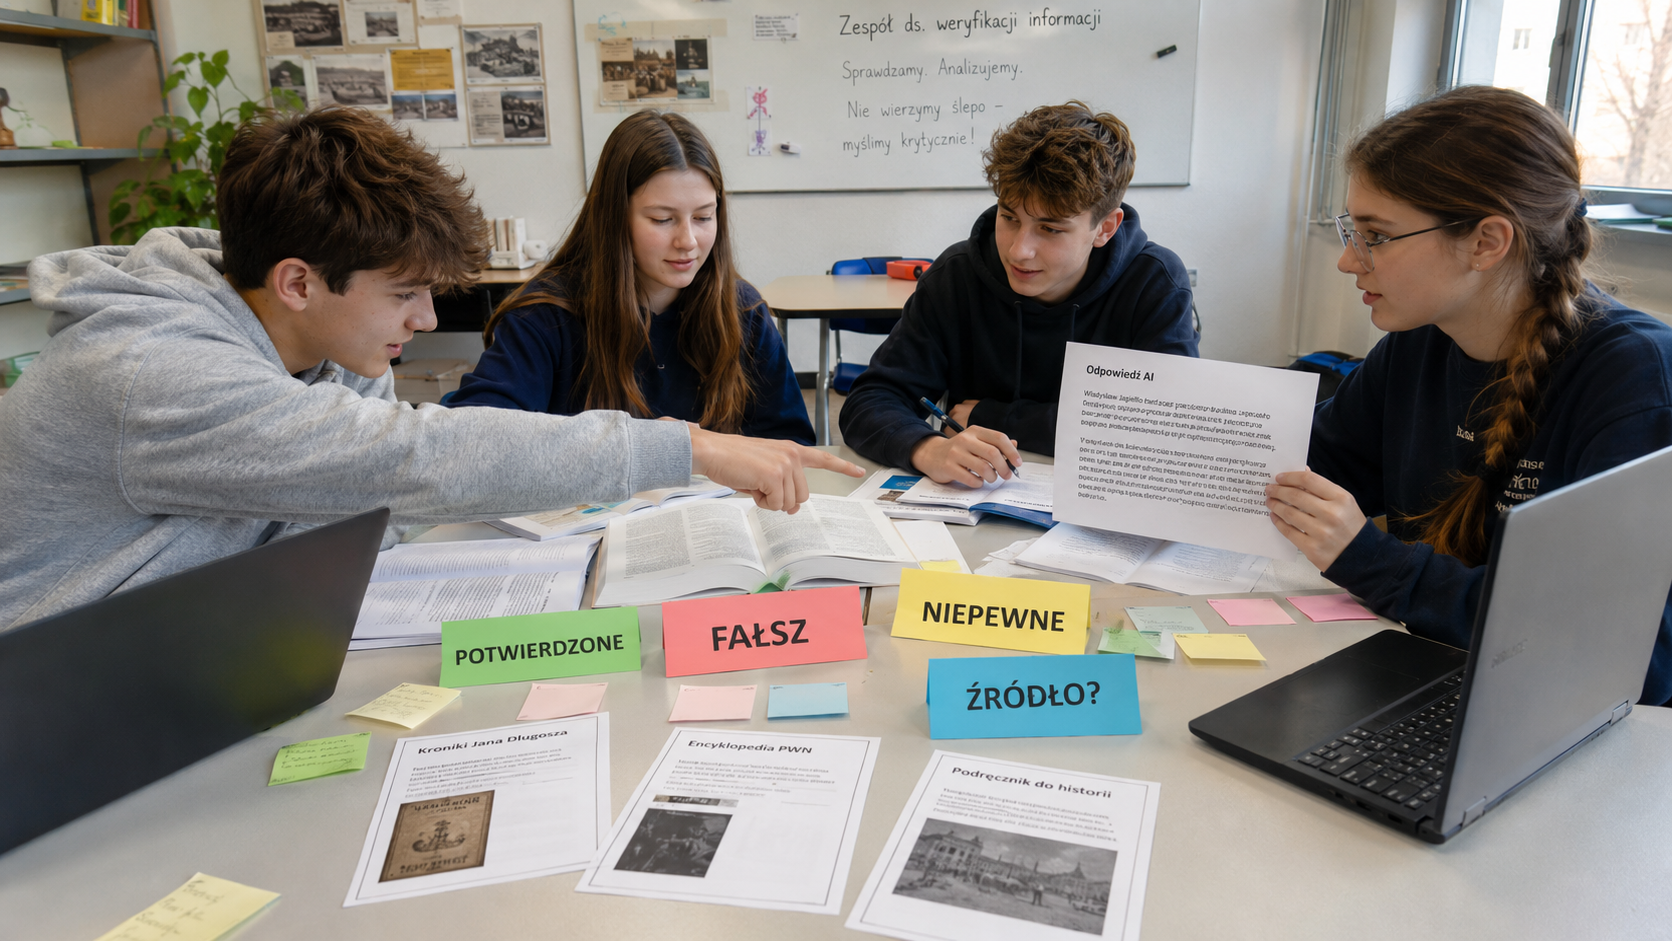 Drugi pomysł na lekcję nazwałem „Bibliografia duchów”. Tym razem uczniowie nie dostają gotowej odpowiedzi od AI do analizy, tylko krótką listę źródeł, które chatbot podobno wykorzystał przy pisaniu tekstu. Nauczyciel może wcześniej poprosić AI o przygotowanie, powiedzmy, pięciu publikacji na wybrany temat. Najciekawiej robi się wtedy, gdy część tych źródeł istnieje naprawdę, niektóre mają przekręcony tytuł albo nazwisko autora, a jeszcze inne to całkowity wymysł modelu.
Zadanie dla uczniów jest proste: dowiedzieć się, z czym właściwie mają do czynienia. Najpierw sprawdzają, czy publikacja faktycznie istnieje tzn. czy taki artykuł, książka lub raport rzeczywiście został kiedyś opublikowany. Czy autor jest prawdziwy? Czy zgadzają się rok, nazwa czasopisma, wydawnictwo, DOI? Już na tym etapie szybko wychodzi, że nawet bardzo profesjonalnie wyglądający wpis w bibliografii potrafi prowadzić donikąd.
Odnalezienie publikacji to nie wszystko. Następny krok to sprawdzenie zgodności. Uczniowie dostają jedno lub dwa zdania, które AI ponoć oparła na danym źródle, i mają sprawdzić, czy rzeczywiście dana publikacja zawiera takie treści. To ważne, bo AI nie musi zmyślić całego źródła- czasem podaje prawdziwą pracę, ale przypisuje jej wniosek, którego autorzy nigdy nie postawili.
Później zespoły oceniają wiarygodność źródła. Czy to artykuł naukowy, dokument instytucji, wpis na blogu, reklama, a może anonimowa strona? Na końcu zostaje pytanie o adekwatność: bo nawet sprawdzone źródło wcale nie musi odpowiadać na to, czego szukamy.
Uczniom można przygotować prostą tabelę:
- źródło -> istnieje/nie istnieje
- co naprawdę mówi
- czy jest wiarygodne
- czy pasuje do pytania
- werdykt
Na koniec warto pokazać uczniom wszystkie źródła obok siebie i spytać, które z nich od początku wydawało im się najbardziej przekonujące. Zwykle ciekawsze od samego wykrycia halucynacji okazuje się rozmowa o tym, dlaczego nas zmanipulowano. Czy zadziałała renoma znanego uniwersytetu? Angielski tytuł? Nazwisko autora? A może po prostu cała ta profesjonalnie wyglądająca bibliografia, której nikt już nie chciał sprawdzać?
Taka lekcja pokazuje jeszcze jedno- w świecie AI przypis to żaden dowód. To tylko punkt wyjścia do własnej weryfikacji.
AI zrobi, co trzeba. Pytanie tylko, czy uczeń faktycznie coś z tego wyniesie?
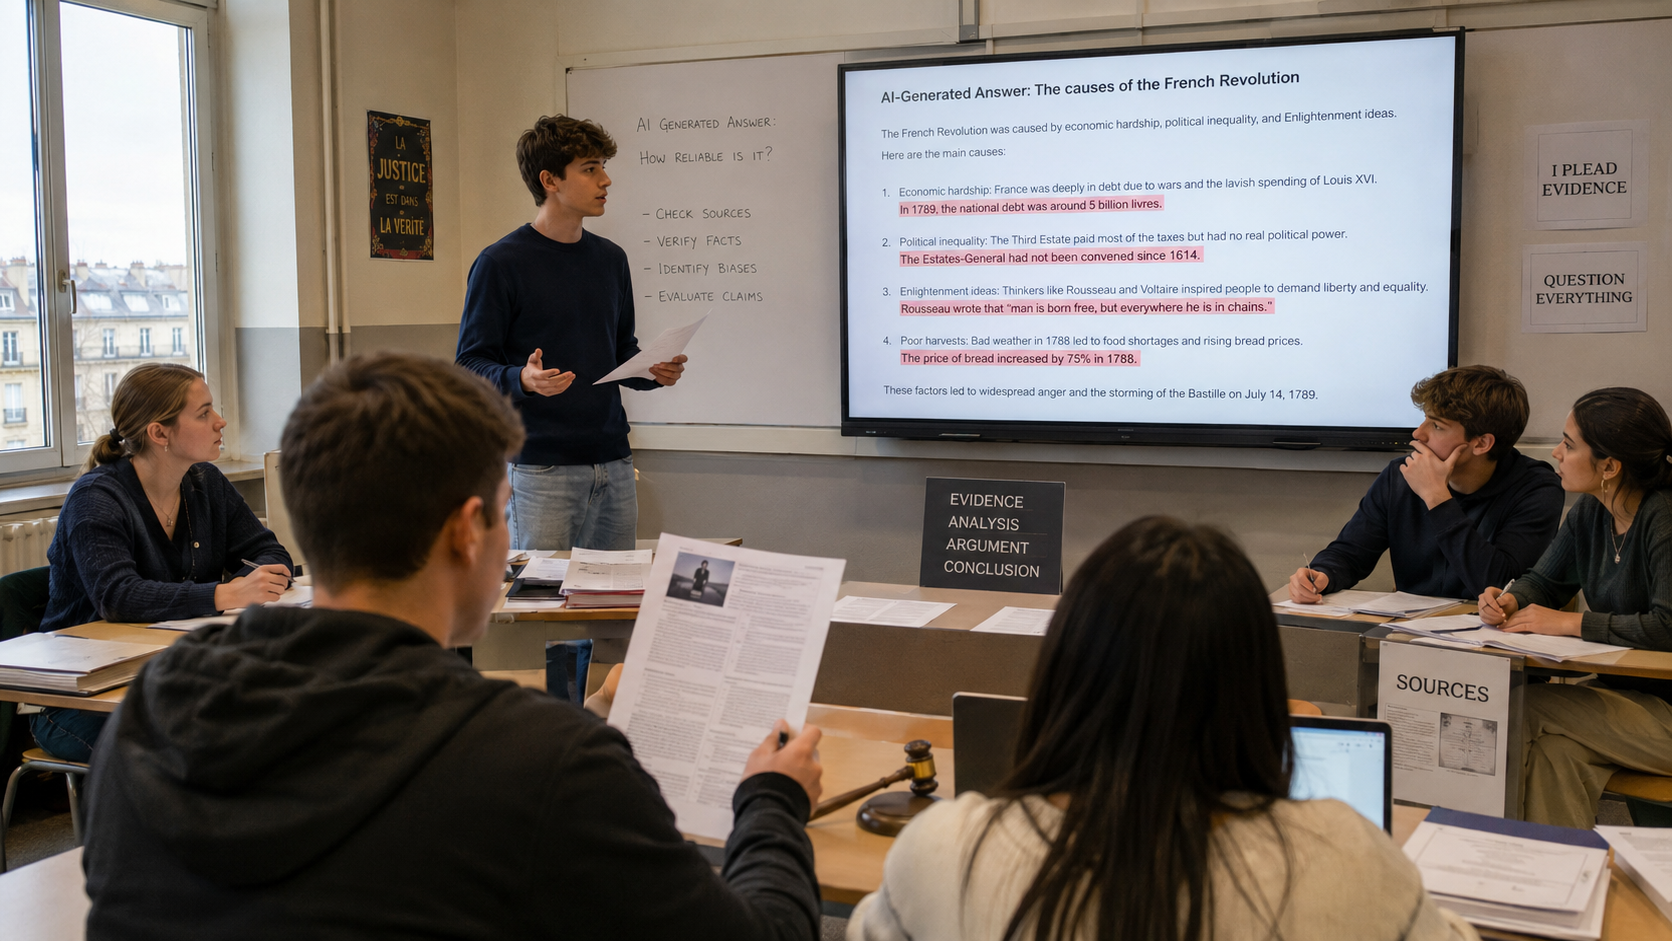 Tradycyjnie w szkole to nauczyciel przygotowuje poprawne materiały, a zadaniem ucznia jest się ich nauczyć. Generatywna AI pozwala czasem przewrócić to do góry nogami. Dostajemy słaby albo niepełny tekst, a rolą ucznia jest doprowadzić go do ładu i rzeczywistości. Każda poprawka wymaga dowodu. Każde źródło trzeba sprawdzić. Za każdym „wydaje mi się” powinno stać „mogę to pokazać”. I może właśnie tu kryje się najciekawszy potencjał edukacyjny AI. Szkoła i tak nie przegra w rywalizacji z chatbotem. Nie musi. Jej siłą jest coś innego: uczenie młodych ludzi zatrzymania się przy nawet najbardziej efektownie brzmiącym zdaniu i zadania prostego pytania: „Skąd to wiemy?” Jeśli uczeń umie odpowiedzieć na nie lepiej niż chatbot, to właśnie „bzdura AI” staje się znakomitym materiałem na lekcję.
To chyba najważniejsze, czego sam się nauczyłem przy pracy nad Digital Citizens. Cyfrowy obywatel to nie osoba z największą ilością aplikacji czy najlepszym promptem. To ktoś, kto wie, że za każdym „publikuj”, „wyślij” czy „użyj tej odpowiedzi” stoi jego własna decyzja. Jeśli AI wygeneruje totalną bzdurę, nie trzeba panikować ani zwalać winy na technologię. To po prostu dobry moment, żeby uczeń poćwiczył odpowiedzialność za własną pracę z informacją.
Jednocześnie, należy dodać coś jeszcze. Stwierdzenie „AI wygenerowała bzdurę. Świetnie!” ma sens tylko, gdy po tym „świetnie” bierzemy się do pracy. Sam błąd nie niesie magicznej wartości edukacyjnej. Jeśli po prostu pokażemy uczniom fałszywy tekst, pośmiejemy się z chatbota i zakończymy lekcję, może się okazać, że zostanie im w głowie właśnie ta fałszywa informacja, razem z niechęcią do „AI slop”.
Uczniowie i tak będą używać sztucznej inteligencji. W szkole, na studiach, w pracy, też w zwykłych, codziennych sprawach. Naszym celem nie powinno być tylko wytykanie błędów, zakazywanie AI ani karanie za jej użycie. O wiele ważniejsze jest, żeby młodzi wiedzieli, jak te narzędzia wykorzystywać z głową: umieć zadać konkretne pytanie, zweryfikować odpowiedź, wyłapać nieścisłości i nie bać się podważyć czegoś, co z pozoru brzmi całkiem sensownie. Bo w świecie AI liczyć się będzie nie tyle umiejętność wygenerowania odpowiedzi, ile prawdziwa sztuka jej oceny.
Źródła
Tekst powstał w oparciu o przegląd badań dotyczących błędów i halucynacji generatywnej AI oraz jej wpływu na naukę, a także na najnowszych wytycznych dotyczących wykorzystania sztucznej inteligencji w edukacji. W szczególności wykorzystano prace Kalai i zespołu na temat „zgadywania” przez modele językowe, badania Bastaniego i współautorów o wpływie AI na naukę oraz koncepcję Sarah Elaine Eaton, która proponuje używanie celowo błędnych treści AI do ćwiczenia sprawdzania faktów.
W kontekście edukacji wykorzystano także raport NASK „Generatywna sztuczna inteligencja w polskiej szkole. Przecieranie szlaków”, OECD Digital Education Outlook 2026, ramy kompetencji AI UNESCO oraz wytyczne Komisji Europejskiej dotyczące etycznego korzystania ze sztucznej inteligencji i danych w edukacji.
Grafika wygenerowana przy użyciu AI.
Michał Siwkowski
nauczyciel języka angielskiego w Zespole Placówek Edukacyjnych w Olsztynie
ambasador programu eTwinning, ekspert Erasmus+ i Europejski Korpus Solidarności
członek ESEP Pool of Experts oraz moderatorem europejskiej grupy „Digital Skills for Pupils and Teachers”
W swojej działalności szczególnie koncentruje się na wykorzystaniu nowych technologii i sztucznej inteligencji w edukacji, kompetencjach cyfrowych, edukacji włączającej oraz międzynarodowej współpracy szkół.